Эмель Садыкоглу и Севилай Демиркесен
Технический университет Гебзе, Коджаэли, Турция
esadikoglu@gtu.edu.tr; demirkesen@gtu.edu.tr
Европейская конференция по вычислительным технологиям в строительстве 2025 года и конференция CIB W78 по информационным технологиям в строительстве. Порту, Португалия, 14–17 июля 2025 года.
Оригинальное название: Review of Machine Learning and Artificial Intelligence Use for Cost Estimation in Construction Projects. DOI: 10.35490/EC3.2025.363.
Примечание к переводу. Термин cost estimation передан как «оценка стоимости», поскольку статья охватывает прогнозирование стоимости на разных стадиях проекта. Библиографические записи сохранены на языке оригинала. Рисунки воспроизведены из исходной статьи; перевод их текстовых обозначений приведён под рисунками. Примечания переводчика отделены от авторского текста.
Аннотация
Оценка стоимости является важнейшей задачей управления строительными проектами, влияющей на успешность их реализации. В последнее время методы машинного обучения и искусственного интеллекта стали эффективными инструментами оценки стоимости строительных проектов благодаря способности формировать точные прогнозы. В статье представлен систематический обзор литературы о применении методов машинного обучения и искусственного интеллекта для оценки стоимости строительства. Обзор выполнен по методике PRISMA и охватывает 75 публикаций. Проведён комплексный анализ существующих исследований, включая сбор данных, характеристики проектов и модели прогнозирования. Работа углубляет понимание возможностей машинного обучения и искусственного интеллекта в оценке стоимости строительства и помогает лицам, принимающим решения, и исследователям разрабатывать точные модели.
Введение
Специфика строительных проектов требует значительных капиталовложений как на начальном этапе, так и на протяжении всей реализации проекта (Wang and Ashuri, 2017). Оценка стоимости — один из наиболее важных этапов управления строительным проектом. Прогнозирование стоимости имеет большое значение для формирования бюджета и распределения ресурсов. Учитывая временной разрыв между первоначальной оценкой и фактическим строительством, необходимо принимать во внимание возможные изменения стоимости во времени (Wang and Ashuri, 2017). Завышение или занижение оценки приводит к отклонениям между ожидаемыми и фактическими затратами, что вызывает серьёзные проблемы.
Получение исходных данных для оценки стоимости затруднено, если состав и объём работ определены нечётко. Точность оценки меняется в течение жизненного цикла проекта: на ранних стадиях она ниже из-за ограниченности проектных решений, документации и информации. По мере реализации проекта, уточнения состава работ и конкретизации технических требований оценки становятся более точными и надёжными (Hashemi et al., 2020; Kumar et al., 2023). Точность прогнозов существенно влияет на успех или неудачу проекта. Поэтому получение простой и точной оценки стоимости на предварительной стадии остаётся одной из наиболее сложных задач управления строительными проектами (Meharie et al., 2022).
Возможности традиционных методов в обеспечении точных прогнозов ограничены. Чтобы устранить неточности и ошибки оценки стоимости, в исследованиях всё чаще применяются системные подходы, включающие математические модели, методы машинного обучения и другие передовые методы, позволяющие получать более надёжные прогнозы (Hashemi et al., 2020). Методы машинного обучения (ML) и искусственного интеллекта (AI) широко используются при оценке стоимости строительных проектов прежде всего благодаря способности давать точные прогнозы без чрезмерной зависимости от экспертных суждений или заранее установленных правил (Meng et al., 2024).
Для повышения качества и точности прогнозирования стоимости предложены различные методы: искусственные нейронные сети (ANN), гибридные модели, рассуждение на основе прецедентов (CBR), регрессионный анализ (RA), деревья решений (DT) и метод опорных векторов (SVM) (Hashemi et al., 2020). Цель настоящей работы — углублённый обзор литературы о методах ML и AI, используемых для прогнозирования стоимости строительства. Для этого рассмотрены 75 публикаций. Несмотря на наличие значительного числа работ, данное направление продолжает быстро развиваться. Поэтому основное внимание уделено недавним публикациям, отражающим современные тенденции и практику применения.
Метод исследования
Проведён систематический обзор литературы на основе методики PRISMA — рекомендуемых требований к представлению результатов систематических обзоров и метаанализов.
Методика PRISMA, задающая структурированный порядок проведения систематических обзоров (Page et al., 2020), представлена на рисунке 1. Для поиска использовалась база Scopus. Поисковый запрос имел следующий вид:
TITLE-ABS-KEY((cost OR budget OR financ*) W/5 (predict* OR estimat* OR forecast* OR projection) AND («machine learn*» OR «artificial intelligence» OR «deep learning») AND («construction project» OR «civil engineering project» OR «building project»))
Публикации на языках, отличных от английского, исключались. Рассматривались работы за 2000–2024 годы; по типу документов отбирались журнальные статьи и материалы конференций. На этапе предварительного отбора анализировались названия, аннотации и ключевые слова. Затем изучались полные тексты статей. Критериями включения были: i) непосредственная направленность исследования на оценку стоимости; ii) использование хотя бы одного метода машинного обучения, искусственного интеллекта или глубокого обучения; iii) рассмотрение строительных проектов.
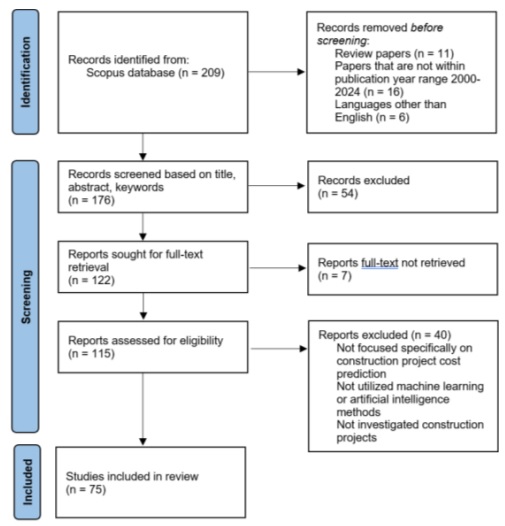

Рисунок 1. Схема отбора статей для обзора
Перевод схемы. Выявление: найдены записи в Scopus — 209. До предварительного отбора исключены обзоры — 11, публикации вне периода 2000–2024 годов — 16, работы не на английском языке — 6. Предварительный отбор по названию, аннотации и ключевым словам — 176 записей; исключены — 54. Запрошены полные тексты — 122; не получены — 7. Оценены на соответствие критериям — 115; исключены — 40 (не посвящены непосредственно прогнозированию стоимости строительного проекта; не используют ML или AI; не рассматривают строительные проекты). В обзор включены 75 исследований.
Характеристика рассмотренных исследований
Для выявления тенденций и закономерностей проанализирована описательная статистика рассмотренных исследований. На рисунке 2 показано количество работ по годам. До 2019 года публикаций было сравнительно немного. В целом график показывает медленный, но устойчивый рост их числа. В последние годы наблюдается быстрое усиление интереса к методам ML и AI, особенно заметное в 2024 году.
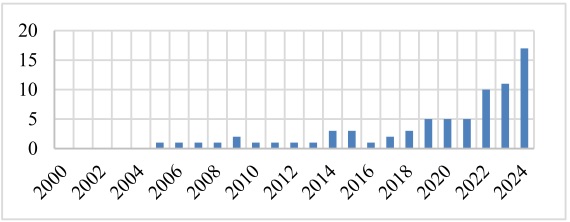

Рисунок 2. Количество исследований по годам
По горизонтали — год публикации; по вертикали — количество исследований.
На рисунке 3 представлено распределение числа исследований по изданиям. Диаграмма позволяет выделить основные источники публикаций. Ведущим журналом является Automation in Construction, за которым следуют Asian Journal of Civil Engineering и Applied Sciences.
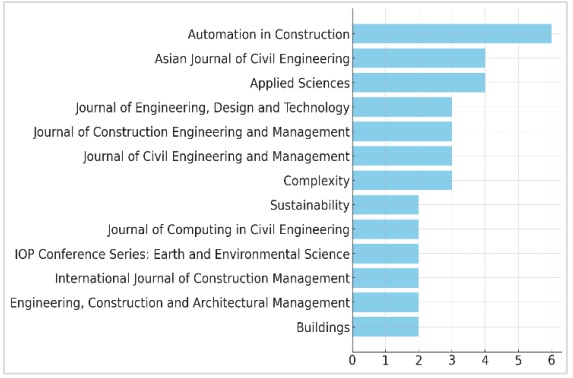

Рисунок 3. Количество исследований по журналам
По горизонтали — количество исследований. Названия журналов сохранены на языке оригинала.
Анализ рассмотренных исследований
Тип проекта
Почти во всех исследованиях разрабатывалась модель для определённого типа сооружений. Следовательно, ожидается, что такие модели лучше всего описывают и прогнозируют стоимость именно тех сооружений, для которых они созданы. Обычно исследования ограничиваются одним типом проектов из-за различий в их характеристиках.
Значительная часть работ посвящена строительству зданий. Во многих исследованиях рассматривались инфраструктурные проекты: мосты, автомобильные дороги, метрополитен, водопроводные и канализационные сети. Изучались также государственные строительные проекты, в том числе административные и учебные здания. Промышленные проекты представлены немногочисленными исследованиями строительства заводских зданий и проектов EPC в энергетике, охватывающих проектирование, закупки и строительство. Отдельные работы посвящены специализированным строительным проектам. На рисунке 4 приведено распределение исследований по типам проектов: преобладают здания, тогда как другие типы представлены ограниченно.
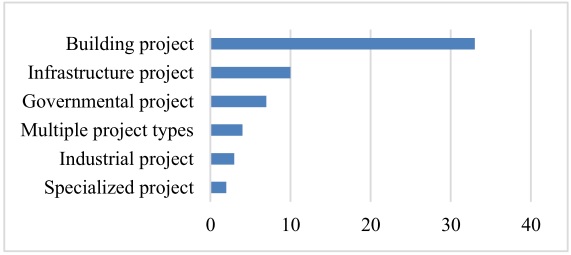

Рисунок 4. Количество исследований по типам проектов
Сверху вниз: строительство зданий; инфраструктурные проекты; государственные проекты; несколько типов проектов; промышленные проекты; специализированные проекты. По горизонтали — количество исследований.
Стадия проекта
Методы оценки стоимости строительства зависят от стадии проекта, его целей и объёма доступной информации. На стадии инициирования информация ограничена, а основная задача состоит в определении осуществимости проекта. Предварительные оценки на этой стадии обычно опираются на простые и быстрые методы расчёта. Обеспечение точности на ранних стадиях затруднено (Miranda et al., 2022). Значительная часть исследований посвящена концептуальной оценке стоимости; при определении общей стоимости строительства преимущественно используются показатели площади, объёмов и стоимости. Meng et al. (2024) оценивали стоимость строительства метрополитена на стадии инициирования проекта.
В рассмотренных работах преобладает стадия проектирования. Cheng et al. (2009) прогнозировали стоимость на стадиях концептуального и предварительного проектирования. В некоторых работах прогноз выполнялся на стадии детального проектирования с оценкой стоимости отдельных элементов здания (Banihashemi et al., 2022; Cheng et al., 2010). Для стадии проведения Chou et al. (2015) прогнозировали цену, по которой будет присуждён контракт на строительство моста. Kusonkhum et al. (2022) оценивали на стадии торгов стоимость различных государственных проектов, включая здания и дороги. Car-Pušić and Mlađen (2020) изучали соотношение фактической стоимости строительства и договорной цены, сформированной по результатам торгов.
На стадии строительства руководители проектов обычно оценивают затраты с помощью метода управления освоенным объёмом (EVM), который позволяет прогнозировать итоговые затраты на момент завершения, отслеживать состояние проекта и измерять показатели его выполнения (Cheng and Hoang, 2014). Cheng and Hoang (2014) разработали комплексную модель для планирования и контроля затрат на стадии строительства. Cheng and Roy (2011) прогнозировали денежные потоки строительного проекта с использованием временных рядов. Cheng and Khasani (2024) предложили комплексную модель, обеспечившую более высокое качество прогноза по сравнению с методом освоенного объёма.
Немногие исследования охватывали стадию эксплуатации и технического обслуживания (O&M). An (2023) разработал систему раннего предупреждения об отклонениях затрат на этих стадиях для крупных строительных проектов. Kim et al. (2024) предложили модель глубокого обучения для оценки затрат на ремонт и техническое обслуживание многоквартирных домов.
Этапы исследования
Этапы разработки моделей прогнозирования показаны на рисунке 5. Сначала определяется проблема и формулируются цели исследования. Затем устанавливаются входные и выходные параметры, также называемые признаками, переменными или позициями. На этапе сбора данных получают соответствующую информацию о ранее реализованных проектах, из баз данных или из конкретных примеров. Собранные данные предварительно обрабатывают, очищают и подготавливают к анализу.
В некоторых исследованиях применяется разведочный анализ данных, позволяющий лучше понять распределение, закономерности и взаимосвязи. Кроме того, для улучшения модели в отдельных работах отбираются наиболее значимые признаки. На этапе выбора метода определяются подходящие методы и параметры модели. При анализе данных оцениваются выходные результаты разработанной модели. Затем модель обучается, а качество её работы оценивается по соответствующим метрикам. Для проверки способности модели обобщать результаты используются методы валидации. После этого модель можно испытать и применять.
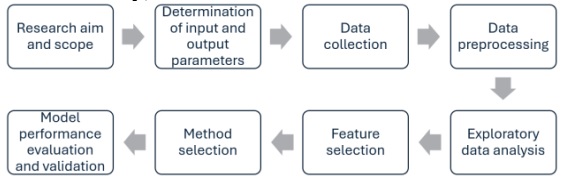

Рисунок 5. Этапы разработки модели прогнозирования по Shmueli и Koppius 2010
Последовательность на схеме: цель и границы исследования → определение входных и выходных параметров → сбор данных → предварительная обработка → разведочный анализ → отбор признаков → выбор метода → оценка качества и валидация модели.
Входные и выходные переменные
Выбор входных переменных различается между исследованиями и прежде всего зависит от типа и стадии проекта. Входные переменные, используемые при оценке стоимости строительства зданий на разных стадиях, обобщены в таблице 1.
Таблица 1. Входные переменные для зданий на разных стадиях проекта
| Стадия проекта | Входные переменные |
| Предпроектная стадия и проектирование | Продолжительность, местоположение, год, тип и высота здания, общая площадь этажей, число этажей, высота этажа, тип фундамента, грунтовые условия, сейсмическая зона, переменные проектных решений, материалов и других элементов здания, экономические переменные. |
| Строительство | Характеристики проекта (общая площадь, продолжительность); показатели хода и эффективности выполнения (прогресс строительства, освоенный объём, фактические затраты, индексы выполнения сроков и стоимости, доля затрат на элемент); переменные, касающиеся контракта (платежи по договору, индексы выставленных счетов субподрядчика и заказчика, индекс изменений по договору); экономические переменные и параметры внешней среды. |
| Эксплуатация и техническое обслуживание | Возраст здания, виды использования, погодные факторы (температура, осадки, скорость ветра, солнечная радиация). |
В предыдущих исследованиях выделены также входные переменные, характерные для инфраструктурных проектов. При оценке стоимости строительства канализационных сетей использовались год, продолжительность, административная территория, вид финансирования, глубина заложения, длина, тип и диаметр трубопровода, количество колодцев, тип грунта, строительная площадка, уровень грунтовых вод, работы на участках с покрытием и без покрытия (Abbas and Aswed, 2024; Juszczyk et al., 2023).
Для оценки стоимости мостов на предпроектной стадии и стадии проектирования учитывались тип конструкции, тип моста и проекта, длина и ширина моста, количество и длина пролётов, высота промежуточных опор, опоры, конструктивное решение, применяемые материалы, способ устройства фундаментов, класс нагрузки и технология строительства (Juszczyk, 2020; Beljkaš and Knežević, 2021). Для стадии торгов по строительству мостов Chou et al. (2015) использовали размер бюджета, срок исполнения, таблицу анализа единичных расценок, количество детальных смет, площадь строительства дороги, площадь верхней части сооружения, количество устоев и промежуточных опор, а также орган, проводящий торги.
На предпроектной стадии и стадии проектирования автомобильных дорог Abd et al. (2024) рассматривали факторы стоимости, включая год реализации проекта, длину дороги, подготовку территории, земляные работы, устройство подстилающего слоя, дорожного покрытия и обочин. Meharie et al. (2022) уделяли внимание количеству мостов, уровню инфляции, рельефу местности и типу проекта. В исследовании Meng et al. (2024) при оценке стоимости метрополитена учитывались длина линии, число станций, расстояния между ними, проектная скорость и экономические переменные.
Исследование Mahdavian et al. (2020), посвящённое стадии строительства автомобильных дорог, опиралось на ретроспективные ежемесячные данные. Kusonkhum et al. (2022) для стадии закупок по государственным строительным проектам использовали местоположение, продолжительность, масштаб и тип проекта, ответственное ведомство и способ проведения торгов.
Во многих работах выходной переменной служила общая стоимость проекта (Jiang, 2020; Juszczyk et al., 2023; Liu et al., 2024). Чаще всего прогнозировалась общая стоимость строительства в долларах, евро или местной валюте либо стоимость строительства на 1 м² (Kong et al., 2008; Cheng et al., 2010; Beljkaš and Knežević, 2021; Liu and Lin, 2024; Das et al., 2024). В отдельных исследованиях прогнозировалась лишь одна составляющая затрат. Большинство работ трактовали прогнозирование стоимости строительного проекта как задачу регрессии, но в некоторых случаях она рассматривалась как задача классификации.
Сбор данных
Во многих исследованиях собирались ретроспективные данные о ранее завершённых проектах: технические характеристики, проектная документация, результаты опросов. Основными источниками были генеральные подрядчики, государственные органы, консалтинговые организации и заказчики строительства. Часто использовались официальные и государственные базы данных, сведения из других научных статей, анкетирование и данные информационных моделей зданий (BIM).
Объём данных существенно влияет на точность модели. С его увеличением уменьшаются дисперсия и смещение выборки. Наименьший набор данных в рассмотренных работах содержал 10 наблюдений. Хотя в большинстве исследований использовались сравнительно небольшие наборы, встречались и исключительно крупные. На рисунке 6 представлена гистограмма распределения объёмов выборок. Большинство исследований использует менее 200 наблюдений, что указывает на преимущественную опору на относительно небольшие наборы данных.
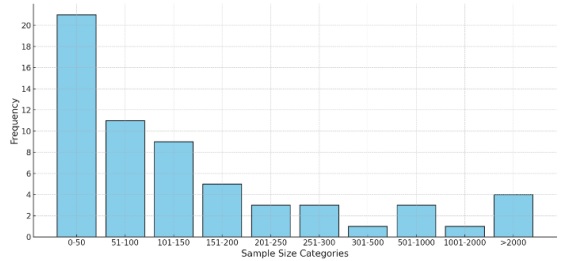

Рисунок 6. Гистограмма объёмов выборок в рассмотренных исследованиях
По горизонтали — категории объёма выборки; по вертикали — частота. Категории: 0–50; 51–100; 101–150; 151–200; 201–250; 251–300; 301–500; 501–1000; 1001–2000; более 2000 наблюдений.
Обычно исследователи собирали данные и проверяли результаты применительно к одной стране. В совокупности рассмотренные работы охватывают множество стран мира. На рисунке 7 показано географическое распределение наборов данных. Наибольшее число исследований приходится на Азию: лидируют Китай, Тайвань и Корея; далее следуют европейские страны, в том числе Польша и Великобритания.
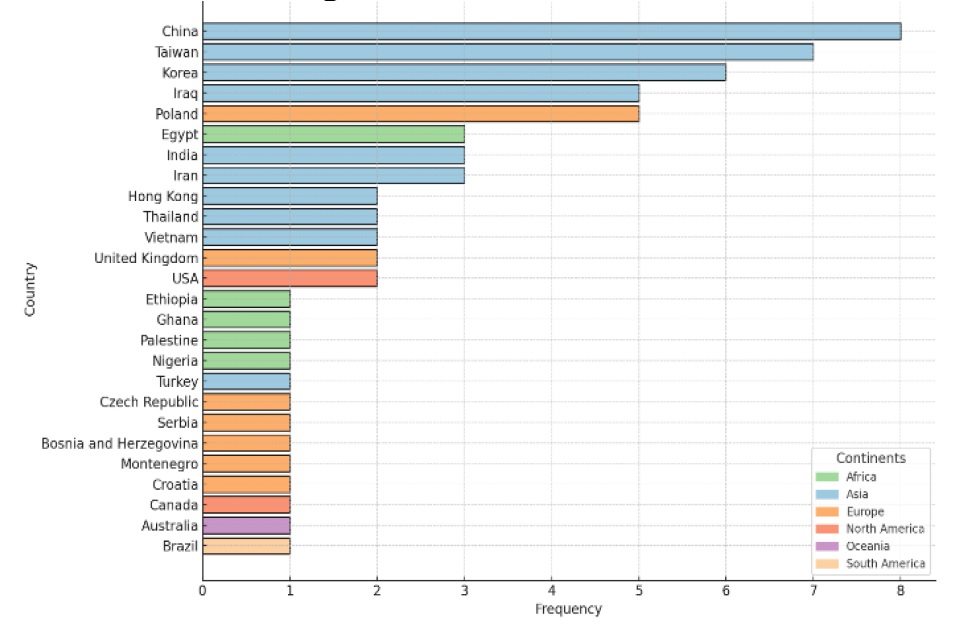

Рисунок 7. Географическое распределение наборов данных
По горизонтали — частота; по вертикали — страна. Сверху вниз: Китай, Тайвань, Корея, Ирак, Польша, Египет, Индия, Иран, Гонконг, Таиланд, Вьетнам, Великобритания, США, Эфиопия, Гана, Палестина, Нигерия, Турция, Чехия, Сербия, Босния и Герцеговина, Черногория, Хорватия, Канада, Австралия, Бразилия. Легенда: Африка, Азия, Европа, Северная Америка, Океания, Южная Америка.
На рисунке 8 показаны временные интервалы, охватываемые наборами данных. Наиболее продолжительный период сбора данных составил 22 года — в работах с интервалами 1993–2015 и 2000–2022 годов. Самый короткий период составлял один год — в исследованиях, использовавших данные за 2008 и 2019 годы.
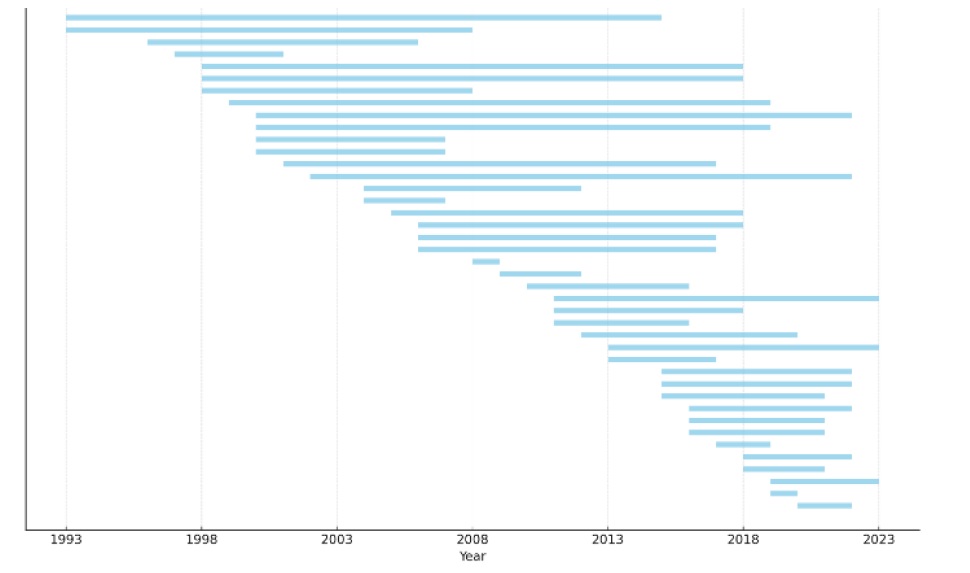

Рисунок 8. Временные интервалы наборов данных
По горизонтали — год. Каждый горизонтальный отрезок показывает период, охваченный одним набором данных.
Отбор признаков
Отбор признаков — это выбор наиболее подходящих переменных и исключение ненужных из совокупности потенциальных переменных. Эта процедура важна, поскольку выбранные признаки влияют на модель. Во многих работах признаки определялись качественными методами: обзором литературы, экспертными суждениями и анкетированием. Применялись также количественные подходы.
В рамках разведочного анализа данных для сокращения числа параметров используется снижение размерности (Miranda et al., 2022). Во многих исследованиях отбор признаков осуществлялся методом главных компонент — PCA (Jiang, 2020; Liu and Lin, 2024; Abd et al., 2024; Son et al., 2012; Wang et al., 2024a). Использовались и методы на основе регрессии, в частности пошаговая регрессия (Chou et al., 2015) и LASSO (Tajziyehchi et al., 2021).
Выбор метода
Методы ML и AI для оценки стоимости строительства можно разделить на одиночные, ансамблевые и гибридные модели. Одиночная модель предполагает применение одного метода машинного обучения или искусственного интеллекта к поставленной задаче. Она может быть базовой либо производной от базовой модели (Wang et al., 2024b). Для прогнозирования стоимости строительства широко применяются регрессионные модели и искусственные нейронные сети (Mahdavian et al., 2020). Линейная и логистическая регрессии распространены, но их возможности преимущественно ограничиваются выявлением простых и линейных зависимостей. Деревья решений, ANN и SVM способны выявлять сложные закономерности и нелинейные связи, однако подвержены риску переобучения (Miranda et al., 2022).
Один из наиболее распространённых методов прогнозирования стоимости строительства — искусственные нейронные сети. Они выявляют сложные закономерности в данных, но их работа по принципу «чёрного ящика» затрудняет интерпретацию (Meng et al., 2024). Существуют различные развитые разновидности ANN: глубокие нейронные сети (DNN), свёрточные нейронные сети (CNN), сети долгой краткосрочной памяти (LSTM), управляемые рекуррентные блоки (GRU), нейронные сети с обучением методом обратного распространения ошибки (BPNN), многослойный перцептрон (MLP), машина экстремального обучения (ELM) и сети радиально-базисных функций (RBFN). В ряде работ такие разновидности использовались как одиночные модели: DNN (Park and Yun, 2023), BPNN и RBFN (Jiang, 2020), LSTM, рекуррентные нейронные сети (RNN) и GRU (Kim et al., 2024).
Среди регрессионных моделей применялись множественная регрессия, обобщённая линейная регрессия (GENLIN) и многомерные адаптивные регрессионные сплайны (MARS). Sharqi and Bhattarai (2021) использовали ELM, MARS и регрессию методом частичных наименьших квадратов (PLS). Наилучшие результаты показала MARS. В нескольких исследованиях применялись SVM (Cheng and Hoang, 2014) и регрессия на основе опорных векторов (Juszczyk, 2019; Juszczyk, 2020). Kong et al. (2008) сравнили регрессию на основе опорных векторов и RBFN; первая обеспечила более точный прогноз. Car-Pušić and Mlađen (2020) использовали одиночные модели линейной регрессии (LR), обобщённой регрессионной нейронной сети (GRNN), радиально-базисной функции (RBF) и SVM. Лучшие результаты были получены моделью RBF.
Ансамблевые модели объединяют несколько слабых или сильных моделей и агрегируют их прогнозы для повышения точности и устойчивости. Ансамблевые методы включают бэггинг, бустинг, стекинг, усреднение и голосование. Juszczyk et al. (2019) и Juszczyk et al. (2023) создавали ансамбли нейронных сетей, объединяя сети MLP методами простого и обобщённого усреднения. Liu and Lin (2024) объединили DT, BPNN и SVM с помощью взвешенного усреднения. Meharie et al. (2022) предложили стекинговый ансамбль, объединяющий прогнозы LR, SVM и ANN. Он превзошёл каждую из этих моделей по отдельности.
К ансамблям на основе деревьев относятся случайный лес (RF), машина градиентного бустинга (GBM), экстремальный градиентный бустинг (XGBoost), LightGBM (LGBoost), бустинг на основе естественного градиента (NGBoost) и стекинговые деревья решений. Ali et al. (2022) сравнили RF, ANN и SVM; случайный лес превзошёл остальные методы. Chakraborty et al. (2020) сопоставили LR, ANN, RF, XGBoost, LGBoost и NGBoost и установили, что наиболее предпочтительные результаты обеспечивает гибридная модель LGBoost и NGBoost. Ali and Burhan (2023) сравнили XGBoost, ELM и MARS; лучшие результаты показал XGBoost.
Гибридная модель сочетает несколько самостоятельных моделей, чтобы использовать их сильные стороны и компенсировать ограничения (Wang et al., 2024b; Liu and Lin, 2024). Исследователи разрабатывали такие модели для объединения преимуществ различных методов и получения синергетического эффекта. Wang et al. (2024a) предложили гибрид RA + ANN, превзошедший отдельные модели RA, ANN и CBR. De Soto and Adey (2016) разработали гибрид CBR + RA + NN, также показавший лучшие результаты по сравнению с одиночными моделями.
В некоторых работах базовые модели объединяются с алгоритмами оптимизации. Метод роя частиц (PSO), генетический алгоритм (GA) и дифференциальная эволюция (DE) относятся к метаэвристическим алгоритмам оптимизации. Cheng et al. (2009) создали эволюционную нечёткую нейронную модель вывода (EFNIM), объединив нечёткую логику (FL), нейронные сети (NN) и GA. Cheng et al. (2010) разработали эволюционную нечёткую гибридную нейронную сеть (EFHNN), включающую NN, нейронную сеть высокого порядка (HONN), FL и GA. Сравнение показало превосходство EFHNN над EFNIM.
Cheng et al. (2015) предложили адаптивную модель опорных векторов наименьших квадратов с учётом времени (LS-SVMAT), объединяющую LS-SVM, адаптивную функцию времени (ATF) и DE. Du and Li (2017) разработали усовершенствованную BPNN с оптимизацией посредством GA. Mhady et al. (2024) объединили адаптивные нейронечёткие системы вывода (ANFIS) и ANN с алгоритмом оптимизации Архимеда (AOA). По их данным, гибридная модель обеспечила улучшенное прогнозирование при меньшем числе входных параметров.
Оценка качества и валидация моделей
Точность прогнозирования — это способность модели давать точные прогнозы для новых наблюдений. Качество прогнозирования оценивается с помощью метрик точности и подходящего метода валидации (Shmueli and Koppius, 2011; Miranda et al., 2022). Для задач регрессии обычно используются средняя абсолютная ошибка (MAE), средняя квадратичная ошибка (MSE), корень из средней квадратичной ошибки (RMSE) и средняя абсолютная относительная ошибка (MAPE). Для классификации чаще приводятся доля правильных ответов (accuracy), точность положительных предсказаний (precision) и полнота (recall). MAE, MSE и RMSE зависят от масштаба значений, тогда как MAPE не зависит от масштаба и может применяться для сопоставления результатов на разных наборах данных.
Формула MAPE (1) имеет следующий вид (Dang-Trinh et al., 2023), где n — число наблюдений, yₐ — фактическое значение, yₚ — прогнозируемое значение:
MAPE = (1/n) ∑ᵢ₌₁ⁿ |yₚ − yₐ| / yₐ (1)
Примечание переводчика. В исходном перечислении метрик для Mean Square Error ошибочно указано сокращение RMSE; здесь использовано MSE. Формула (1) воспроизведена по оригиналу: она даёт относительную ошибку в долях единицы; для выражения в процентах результат умножается на 100. Индексы отдельных наблюдений в оригинале не проставлены. В исходном тексте множественная регрессия обозначена ML; во избежание смешения с machine learning это сокращение в переводе не использовано.
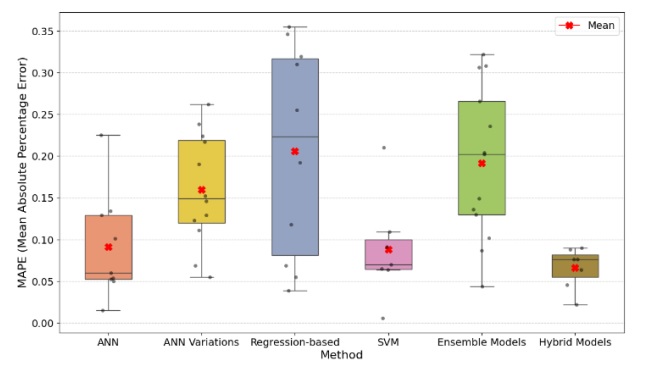

Рисунок 9. Сравнение значений MAPE для различных методов
По вертикали — MAPE, средняя абсолютная относительная ошибка в долях единицы. По горизонтали: ANN; разновидности ANN; регрессионные модели; SVM; ансамблевые модели; гибридные модели. Mean — среднее значение, обозначенное красным маркером.
На рисунке 9 представлены значения MAPE для различных методов, приведённые в рассмотренных исследованиях. Регрессионные модели характеризуются наибольшими значениями MAPE и широким диапазоном их изменения, что указывает на самое низкое общее качество среди сравниваемых методов. ANN и их разновидности демонстрируют средние значения с большим разбросом; качество в значительной мере зависит от параметров модели. SVM имеет низкие медианные и средние значения MAPE и представляет собой сильную альтернативу, особенно для небольших наборов данных. Ансамблевые модели обладают значительным потенциалом, но требуют тщательной настройки параметров. Гибридные модели показывают самые низкие медианные и средние значения MAPE, обеспечивая высокую точность за счёт сочетания сильных сторон разных методов.
Перекрёстная проверка — распространённый способ оценки качества моделей машинного обучения через проверку их способности обобщать результаты на новые данные. Она используется для итоговой оценки прогнозирования. При проверке с выделенной контрольной выборкой (holdout) данные делятся на обучающий и тестовый наборы (Miranda et al., 2022). При k-блочной перекрёстной проверке весь набор поочерёдно используется для обучения и валидации: каждый блок по очереди становится проверочным (Park and Yun, 2023). Чаще всего применялись 5-блочная и 10-блочная проверки. Проверка с исключением одного наблюдения (LOOCV) — предельный случай, при котором число блоков равно числу наблюдений (Miranda et al., 2022); пример — Car-Pušić and Mlađen (2020).
Точность прогнозирования зависит от типа модели; вместе с тем более высокая точность может сопровождаться снижением интерпретируемости и объективности модели (Miranda et al., 2022). Большинство исследований лишь оценивало и сравнивало точность, не объясняя влияние переменных на стоимость (Liu and Lin, 2024). Интерпретация важна для понимания работы модели. В некоторых исследованиях это ограничение устранялось с помощью SHAP — метода аддитивных объяснений на основе значений Шепли (Meng et al., 2024; Chakraborty et al., 2020; Das et al., 2024).
Обсуждение результатов и выводы
В работе проведён комплексный систематический обзор литературы о применении методов ML и AI для оценки стоимости строительных проектов. Число публикаций свидетельствует о растущем интересе и расширении применения этих методов. Большинство исследований посвящено зданиям. Это может объясняться доступностью данных, тогда как сведения по инфраструктурным и промышленным объектам часто ограничены в доступе и конфиденциальны. Недостаточное число работ по другим типам проектов указывает на перспективность изучения инфраструктурных, государственных, промышленных и специализированных проектов. Для каждого типа можно определять более специфические переменные. Кроме того, для расширения области применимости можно создавать комплексные модели, охватывающие несколько типов проектов.
Стадия проекта существенно влияет на точность оценки стоимости. Основное внимание уделялось стадиям планирования и разработки концепции; немало работ охватывало проектирование. На ранних стадиях прогнозы имеют больший разброс из-за недостатка информации и деталей. В исследованиях стадий планирования и концепции обычно используется меньше переменных, что повышает неопределённость по сравнению с моделями для более поздних стадий — проведения торгов или строительства. Недостаток работ по оценке затрат на стадии строительства наблюдается и применительно к эксплуатации и техническому обслуживанию. Большинство исследований сосредоточено на планировании и концептуальном проектировании. Поэтому рекомендуется разработать новую модель прогнозирования, специально предназначенную для оценки стоимости на стадии строительства.
Недостаточно исследована оценка стоимости с позиций различных участников проекта. Большинство работ отражает точку зрения генерального подрядчика или заказчика, тогда как субподрядчики и поставщики материалов остаются без внимания. Однако в строительстве участвует множество сторон, интересы которых необходимо учитывать в более комплексном подходе. Кроме того, не рассматривается влияние вида финансирования и типа договора. В будущие модели прогнозирования следует включать эти факторы.
В предыдущих исследованиях использовался широкий круг входных параметров, но внешние переменные включались ограниченно. Необходимо учитывать экономические факторы и последствия обстоятельств непреодолимой силы, таких как стихийные бедствия, пандемии и войны (Wang et al., 2024b). Например, в некоторых исследованиях на данных развивающихся стран инфляция оказалась наиболее значимым фактором (Ali et al., 2022). При этом в развитых странах со стабильной экономикой её влияние на прогноз может быть менее выраженным. Следовательно, модели должны учитывать параметры, специфичные для конкретной страны.
Наибольшее число исследований выполнено в Азии; значительная часть приходится на Европу, тогда как некоторые развивающиеся регионы представлены недостаточно. Такой географический дисбаланс может быть связан с ограниченными исследовательскими возможностями, нехваткой открытых структурированных наборов данных и слабым сотрудничеством строительной отрасли с научными учреждениями в развивающихся странах. В развитых странах, напротив, обычно лучше доступ к данным, теснее взаимодействие науки и отрасли и более развита технологическая инфраструктура. Дополнительно языковые барьеры и предпочтение региональных изданий могут приводить к неполному учёту исследований. Это указывает на необходимость расширения исследований в странах других континентов для повышения обобщаемости результатов. Средний временной интервал данных по строительным проектам составлял около девяти лет. Для повышения точности прогнозов и обобщаемости моделей можно использовать более длительные периоды наблюдений.
Несмотря на достигнутые результаты, остаётся ряд исследовательских пробелов. Разработка моделей ML и AI для прогнозирования стоимости строительства сложна, поскольку требует качественных и больших наборов данных. Объём данных существенно влияет на точность модели. В строительстве как традиционной отрасли недостаточно развиты хранение, обмен, интеграция и эффективное использование данных. Кроме того, сопротивление изменениям серьёзно препятствует сбору данных и проведению исследований.
Для получения качественных и крупных наборов данных необходимо решать проблемы их сбора, отсутствия стандартизации, несогласованности форматов, безопасности, недостатка прозрачности и доверия. Можно создавать международные платформы совместного обмена данными и обеспечивать региональное финансирование исследований. Следует также разрабатывать новые модели с входными параметрами, учитывающими особенности страны, и создавать гибридные модели на основе наиболее результативных методов для повышения точности прогнозов.
Ожидается, что работа послужит ориентиром для лиц, формирующих отраслевую политику, и практических специалистов при проведении инновационных исследований в строительстве с использованием новейших методов ML и AI. Результаты призваны обозначить основные пробелы предыдущих исследований и стимулировать создание моделей, способных точно прогнозировать стоимость и продолжительность строительных проектов.
Благодарности
Авторы выражают признательность Совету по научно-техническим исследованиям Турции (TÜBİTAK) за поддержку в рамках гранта 2224-A на участие в международных научных мероприятиях.
Список литературы
Abbas, A., & Aswed, G.K. (2024, August). Enhancing Sewage Pipeline Project Cost Estimations in Iraq through Artificial Neural Network Models. In IOP Conference Series: Earth and Environmental Science, 1374(1), p. 012086). IOP Publishing.
Abd, A.M., Kareem, Y.A., & Zehawi, R.N. (2024). Prediction and Estimation of Highway Construction Cost using Machine Learning. Engineering, Technology & Applied Science Research, 14(5), 17222-17231.
Ali, Z.H., Burhan, A.M., Kassim, M., & Al-Khafaji, Z. (2022). Developing an integrative data intelligence model for construction cost estimation. Complexity, 2022(1), 4285328.
Banihashemi, S., Khalili, S., Sheikhkhoshkar, M., & Fazeli, A. (2022). Machine learning-integrated 5D BIM informatics: Building materials costs data classification and prototype development. Innovative infrastructure solutions, 7(3), 215.
Beljkaš, Ž., & Knežević, M. (2021). Use of artificial intelligence for estimating cost of integral bridges. Građevinar, 73(03), 265-273.
Car-Pušić, D., & Mlađen, M. (2020). Early stage construction cost prediction in function of project sustainability. In 15th International Conference on Durability of Building Materials and Components.
Chakraborty, D., Elhegazy, H., Elzarka, H., & Gutierrez, L. (2020). A novel construction cost prediction model using hybrid natural and light gradient boosting. Advanced Engineering Informatics, 46, 101201.
Cheng, M.Y., & Hoang, N.D. (2014). Interval estimation of construction cost at completion using least squares support vector machine. Journal of Civil Engineering and Management, 20(2), 223-236.
Cheng, M.Y., & Khasani, R. R. (2024). Least Square Moment Balanced Machine: A New Approach to Estimating Cost to Completion for Construction Projects. Journal of Information Technology in Construction (ITcon), 29(23), 503-524.
Cheng, M.Y., & Roy, A.F. (2011). Evolutionary fuzzy decision model for cash flow prediction using time- dependent support vector machines. International journal of project management, 29(1), 56-65.
Cheng, M.Y., Tsai, H.C., & Hsieh, W.S. (2009). Web- based conceptual cost estimates for construction projects using Evolutionary Fuzzy Neural Inference Model. Automation in construction, 18(2), 164-172.
Cheng, M.Y., Tsai, H.C., & Sudjono, E. (2010). Conceptual cost estimates using evolutionary fuzzy hybrid neural network for projects in construction industry. Expert Systems with Applications, 37(6), 4224-4231.
Cheng, M.Y., Hoang, N.D., & Wu, Y.W. (2015). Cash flow prediction for construction project using a novel adaptive time-dependent least squares support vector machine inference model. Journal of Civil Engineering and Management, 21(6), 679-688.
Chou, J.S., Lin, C.W., Pham, A.D., & Shao, J.Y. (2015). Optimized artificial intelligence models for predicting project award price. Automation in construction, 54, 106-115.
Dang-Trinh, N., Duc-Thang, P., Nguyen-Ngoc Cuong, T., & Duc-Hoc, T. (2023). Machine learning models for estimating preliminary factory construction cost: case study in Southern Vietnam. International Journal of Construction Management, 23(16), 2879-2887.
Das, P., Kashem, A., Hasan, I., & Islam, M. (2024). A comparative study of machine learning models for construction costs prediction with natural gradient boosting algorithm and SHAP analysis. Asian Journal of Civil Engineering, 1-16.
Du, Z., & Li, B. (2017). Construction project cost estimation based on improved BP Neural Network. In 2017 International Conference on Smart Grid and Electrical Automation (ICSGEA) (pp. 223-226). IEEE.
De Soto, B.G., & Adey, B.T. (2016). Preliminary resource-based estimates combining artificial intelligence approaches and traditional techniques. Procedia engineering, 164, 261-268.
Hashemi, S., Asadi, S., & Sheikholeslami, M. (2020). “A systematic review of machine learning techniques for cost estimation and prediction in construction projects”, Journal of Project Management, 5(3), 85- 105.
Jiang, S. (2020). “Prediction of building cost based on BP neural network”, Journal of Physics: Conference Series, 1437(1), 012071.
Juszczyk, M. (2019). Cost estimates of buildings’ floor structural frames with the use of support vector regression. In IOP Conference Series: Earth and Environmental Science, 222, 012007, IOP Publishing.
Juszczyk, M. (2020). On the search of models for early cost estimates of bridges: An SVM-based approach. Buildings, 10(1), 2.
Juszczyk, M., Hanák, T., Výskala, M., Pacyno, H., & Siejda, M. (2023). Early Fast Cost Estimates of Sewerage Projects Construction Costs Based on Ensembles of Neural Networks. Applied Sciences, 13(23), 12744.
Juszczyk, M., Zima, K., & Lelek, W. (2019). Forecasting of sports fields construction costs aided by ensembles of neural networks. Journal of Civil Engineering and Management, 25(7), 715-729.
Kim, J.M., Yum, S. G., Adhikari, M.D., & Bae, J. (2024). A LSTM algorithm-driven deep learning approach to estimating repair and maintenance costs of apartment buildings. Engineering, Construction and Architectural Management, 31(13), 369-389.
Kong, F., Wu, X.J., & Cai, L.Y. (2008). A novel approach based on support vector machine to forecasting the construction project cost. In 2008 International Symposium on Computational Intelligence and Design, 21-24, IEEE.
Kumar, S., Kumar, V., & Kumar, A. (2023). “Machine learning algorithms for cost estimation in construction projects: A review”, Journal of Building Engineering, 62, 105551.
Kusonkhum, W., Srinavin, K., Leungbootnak, N., Aksorn, P., & Chaitongrat, T. (2022). Government construction project budget prediction using machine learning. Journal of Advances in Information Technology Vol, 13(1).
Liu, Z., & Lin, J. (2024). Combinatorial machine learning approaches for high-rise building cost prediction and their interpretability analysis. Journal of Asian Architecture and Building Engineering, 1-12.
Liu, H., Cheng, J.C., & Anumba, C.J. (2024). A Graph Neural Network Approach to Conceptual Cost Estimation. In ISARC. Proceedings of the International Symposium on Automation and Robotics in Construction (Vol. 41, pp. 815-821). IAARC Publications.
Mahdavian, A., Shojaei, A., Salem, M., Yuan, J.S., & Oloufa, A. A. (2021). Data-driven predictive modeling of highway construction cost items. Journal of Construction Engineering and Management, 147(3), 04020180.
Meharie, M.G., Mengesha, W.J., Gariy, Z.A., & Mutuku, R.N. (2022). Application of stacking ensemble machine learning algorithm in predicting the cost of highway construction projects. Engineering, Construction and Architectural Management, 29(7), 2836-2853.
Meng, C., Qu, D., & Duan, X. (2024). Cost Estimation of Metro Construction Projects Using Interpretable Machine Learning. Journal of Computing in Civil Engineering, 38(6), 04024038.
Mhady, A.A., Budayan, C., & Gurgun, A.P. (2024). Estimate-at-completion (EAC) prediction using Archimedes optimization with adaptive fuzzy and neural networks. Automation in Construction, 166, 105653.
Miranda, S.L., Del Rey Castillo, E., Gonzalez, V., & Adafin, J. (2022). Predictive analytics for early-stage construction costs estimation. Buildings, 12(7), 1043.
Page, M.J., McKenzie, J.E., Bossuyt, P. M.,… & Brennan, S.E. (2020). The PRISMA, et al. statement: an updated guideline for reporting systematic reviews. Bmj, 2021(372), 71.
Park, D., & Yun, S. (2023). Construction Cost Prediction Using Deep Learning with BIM Properties in the Schematic Design Phase. Applied Sciences, 13(12), 7207.
Rafiei, M.H., & Adeli, H. (2018). Novel machine-learning model for estimating construction costs considering economic variables and indexes. Journal of construction engineering and management, 144(12), 04018106.
Son, H., Kim, C., & Kim, C. (2012). Hybrid principal component analysis and support vector machine model for predicting the cost performance of commercial building projects using pre-project planning variables. Automation in Construction, 27, 60-66.
Tajziyehchi, N., Moshirpour, M., Jergeas, G., & Sadeghpour, F. (2021, August). A Methodology and Tool for the Predictive Analysis of Cost Growth in Construction Projects. In 2021 IEEE 22nd International Conference on Information Reuse and Integration for Data Science (IRI) (pp. 240-247). IEEE.
Wang, X., & Ashuri, B. (2017). “Forecasting construction cost index in the short-, mid-, and long-terms using k nearest neighbor and perfect random tree ensembles”, Construction Management and Economics, 35(6), 349- 364.
Wang, Y., Zuo, J., Pan, M., Tu, B., … & Dong, N. (2024a). Cost prediction of building projects using the novel hybrid RA-ANN model. Engineering, Construction and Architectural Management, 31(6), 2563-2582.
Wang, R., Salleh, H., Abdul-Samad, Z., Radzuan, N.F.M., Wen, K. C. (2024b). Fundamentals of Developing Conceptual Cost estimation Models Using Machine Learning Techniques. Planning Malaysia: Journal of the Malaysian Institute of Planners, 3, 242-256.
Примечание переводчика. Список литературы воспроизведён по исходной статье. Внутритекстовые ссылки и библиографические сведения не исправлялись: в оригинале встречаются ссылки на работы, отсутствующие в списке, и расхождения в годах публикации.
Оригинал статьи: https://ec-3.org/publication/ec32025_363/
Об авторе


